Full Page OCR
ภาพรวม Full Page OCR
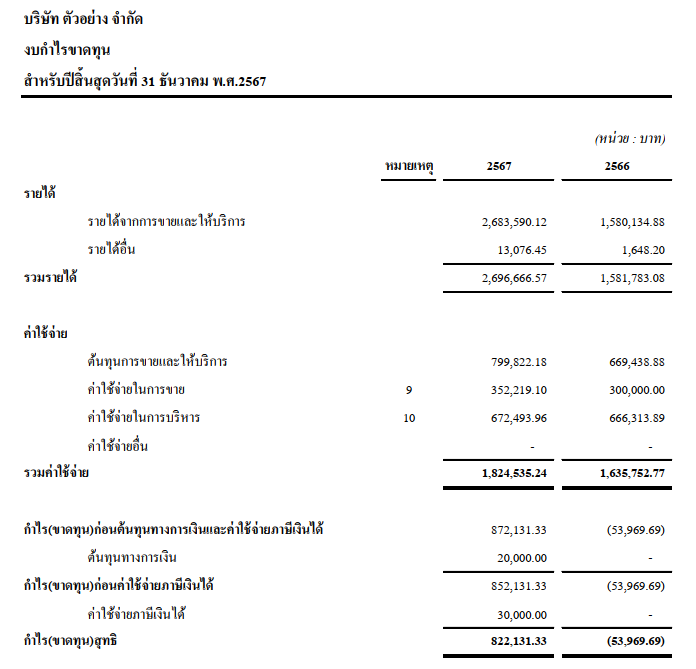
Full Page OCR อ่านข้อความทั้งหน้า — ใบเสร็จ รายงาน สแกนเอกสาร — แล้วคืน Markdown / ข้อความ ใช้เมื่อต้องการเนื้อหาเต็มหน้า ไม่ใช่ JSON ตามฟิลด์
เหมาะเมื่อไหร่
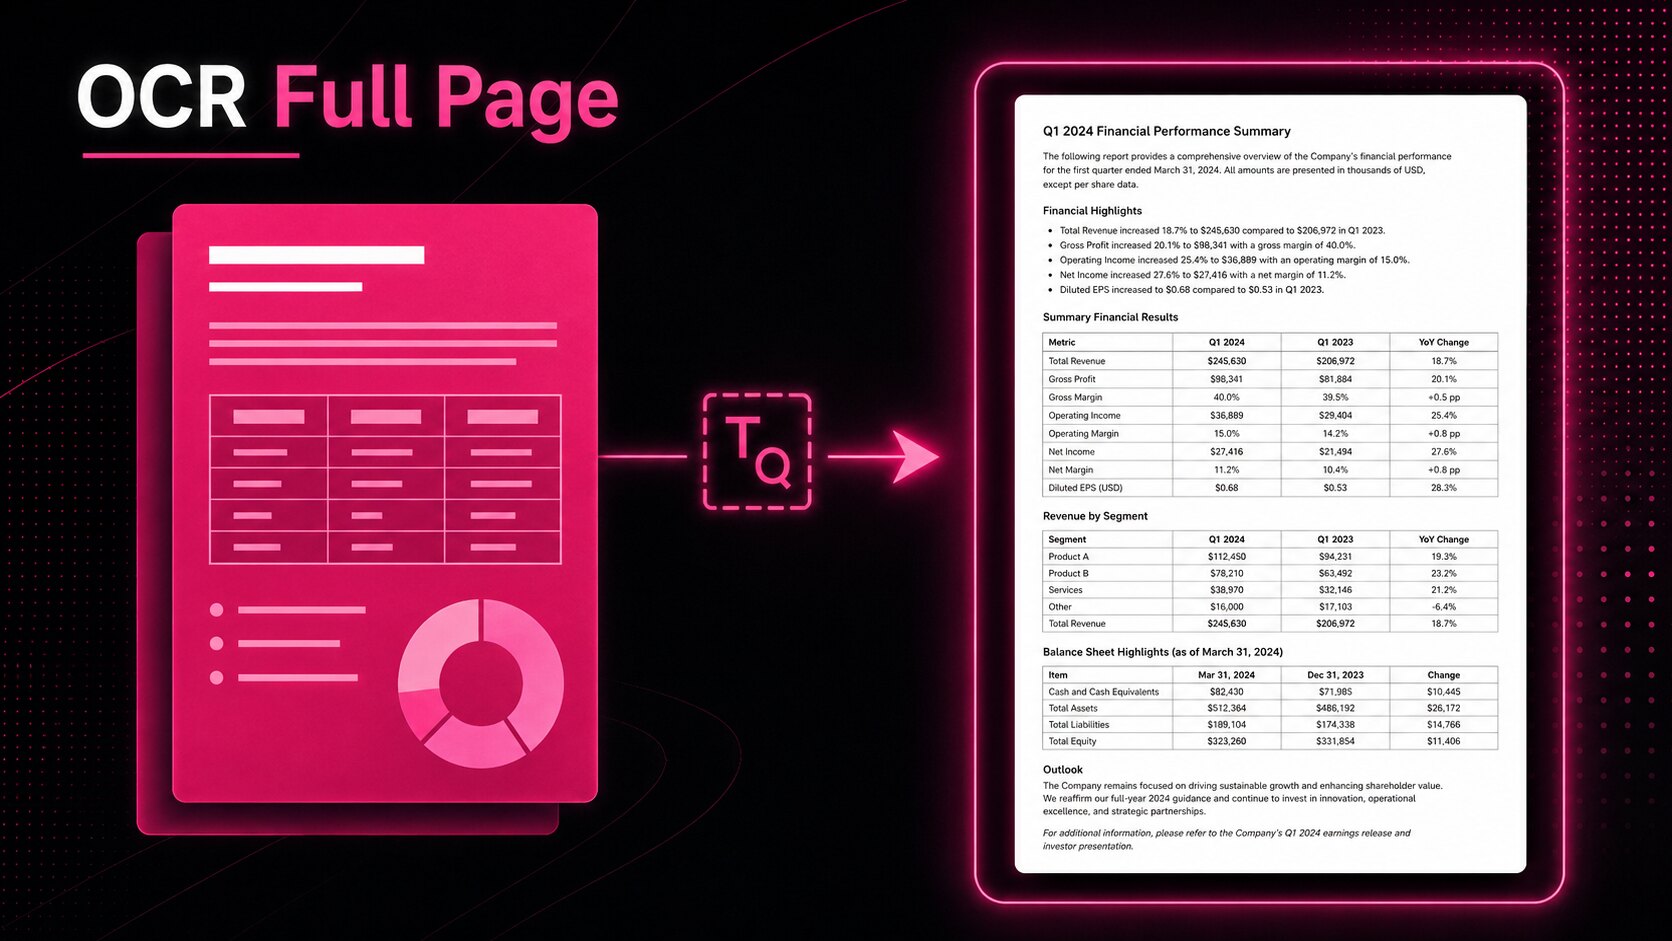
- ต้องการข้อความทั้งหน้าไปเข้า LLM, ค้นหา หรือเก็บคลังเอกสาร
- เอกสารหลายรูปแบบที่ไม่มี schema ตายตัว
- อยากทดลองใน Dashboard ก่อนเขียนโค้ด — โหมดเดียวกับที่เห็นในภาพ
ต้องการ JSON ตามฟิลด์ + bounding box?
ใช้ Key Extraction ไม่ใช่ Full Page OCR
ตัวอย่างเอกสาร
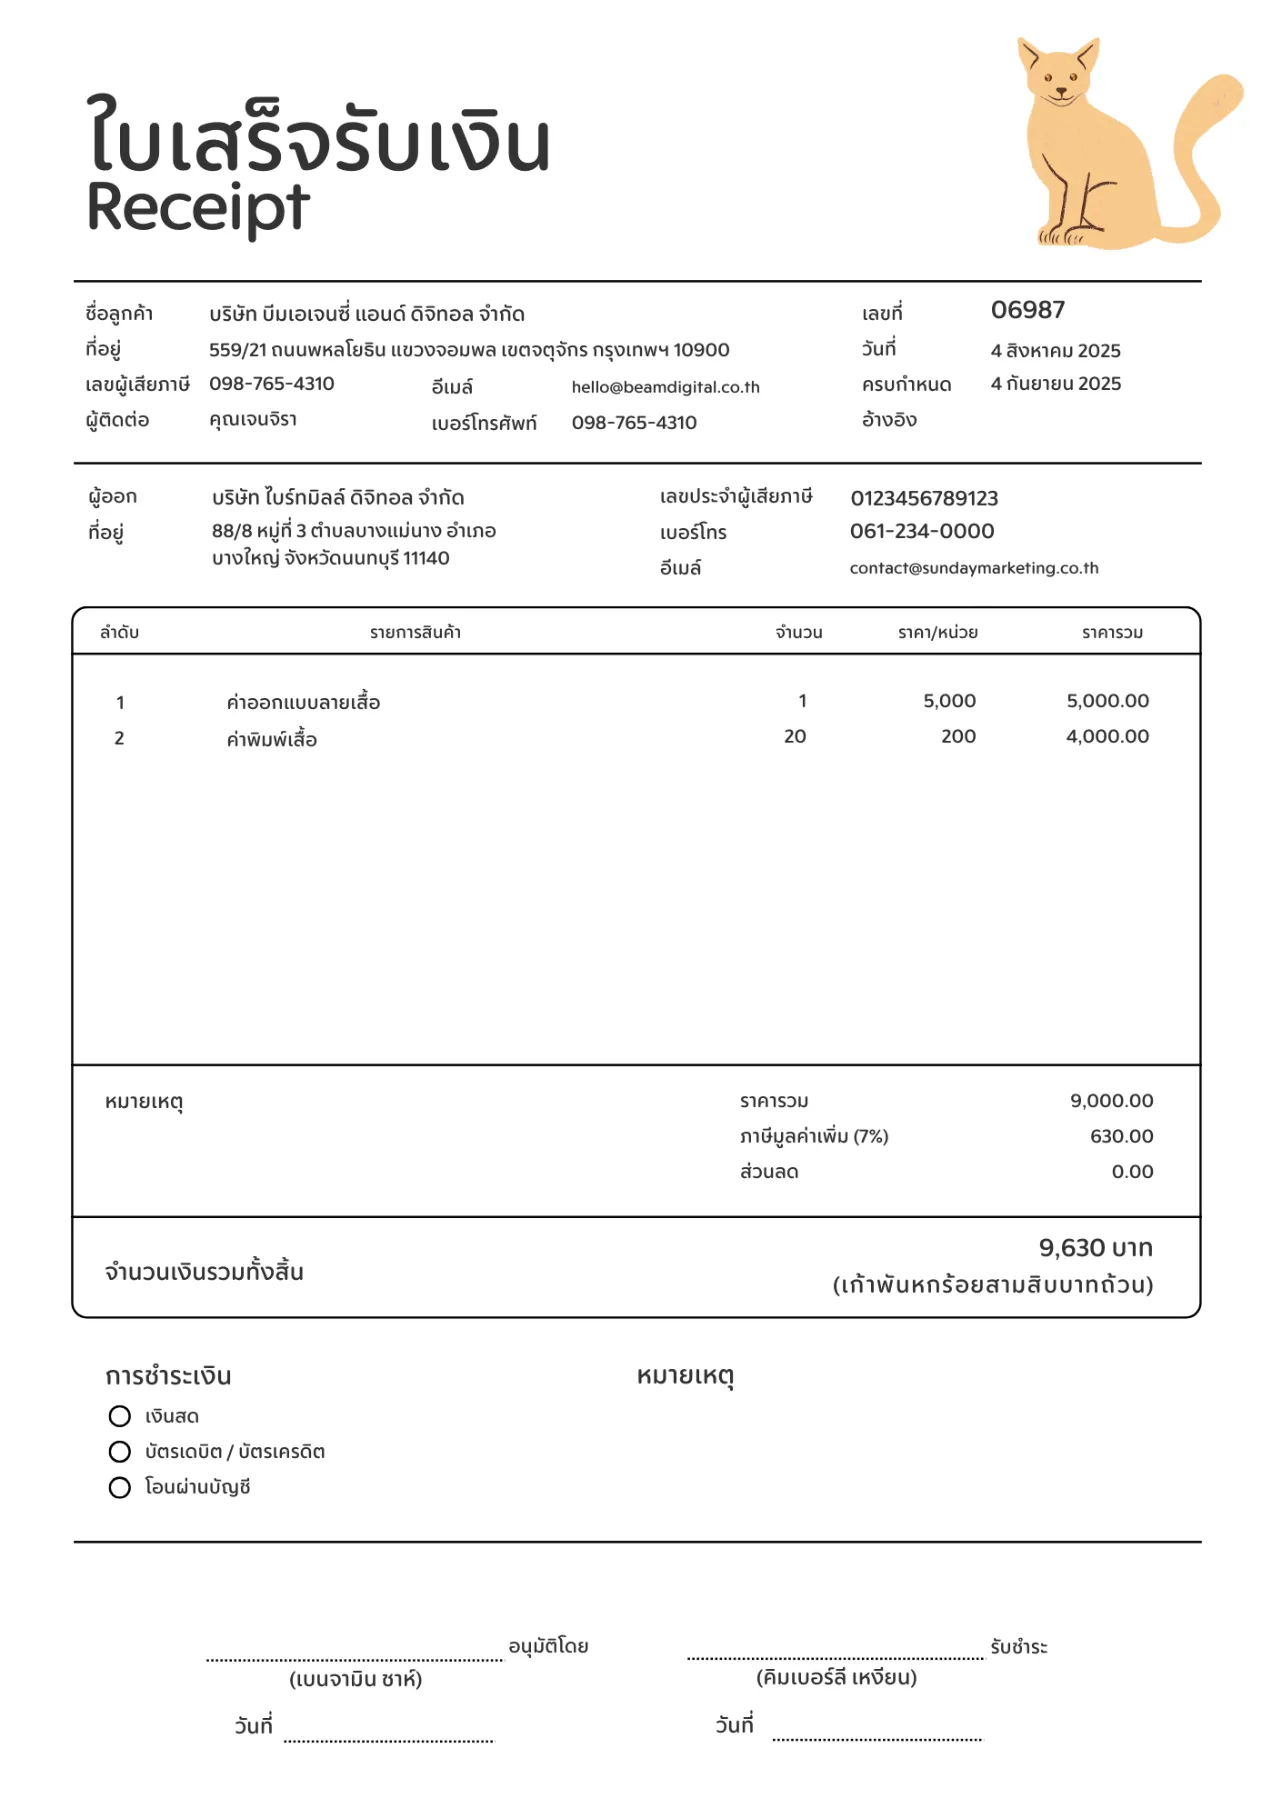
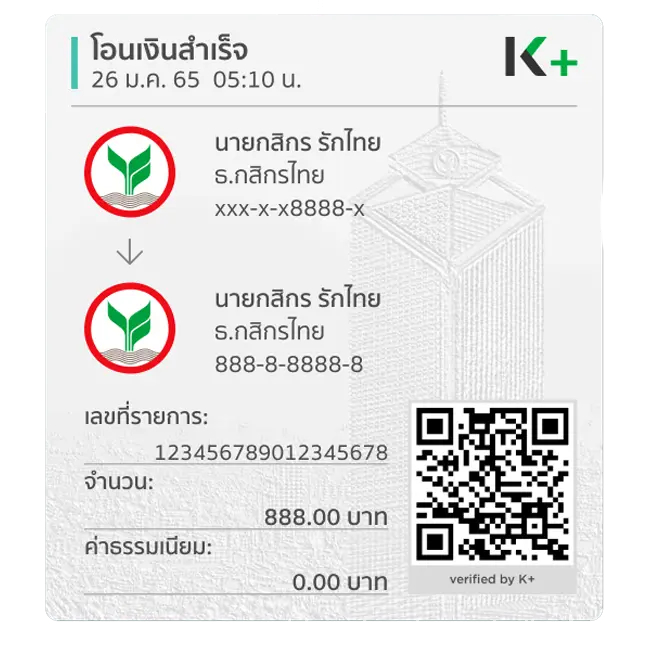
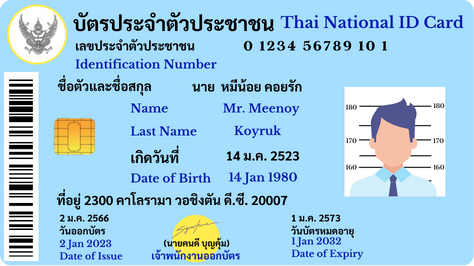
คลิกเอกสารเพื่อดู request และผล Markdown จริงของเอกสารนั้น
เลือกโหมด: Sync หรือ Async
Full Page OCR เป็นผลิตภัณฑ์เดียว เรียกได้ 2 โหมด ผลลัพธ์เป็น pages[].markdown เหมือนกัน
| API | โหมด | ใช้เมื่อ |
|---|---|---|
| OCR v2 | sync | ผลทันที ≤ 50 หน้า / 10 MB |
| OCR v3 transcribe | async job | เอกสารยาว webhook สูงสุด 1,000 หน้า |
ภาพรวมการทำงาน
1
ส่งเอกสาร
อัปโหลดไฟล์หรือส่ง URL สาธารณะ
2
เลือกโมเดล
AksonOCR-1.0, preview หรือ handwriting
3
ได้ข้อความ
pages[].markdown ของทุกหน้า